


Keine Produkte
Prices are shown in Polish złoty (PLN).
Choose your currency:
Preise in Złoty – du kannst die Währung jederzeit oben auf der Seite ändern.
- Klassische Würfel
- Puzzles
- Pyraminx 132
- Megaminx 144
- Minx+ 42
- Skewb 93
- Square-1 37
- Clock 38
- FTO und CTO 19
- Mirror 64
- Gear 41
- Shape-Mods 201
- Axis, Fisher und Windmill 43
- Ghost 10
- Mixup 15
- Crazy und Bermuda 45
- Void und Bandaged 32
- Ausgefallene Cubes 20
- Cuboids 78
- Pyra/Mastermorphix 32
- Helicopter, Dino und Rex 33
- Polyeder 102
- Snake 47
- Magic 3
- Rainbow Ball 8
- Klotski 22
- Knobelspiele 62
- Fidget Toys 24
- Figuren 37
- Bilderwürfel 26
- Schlüsselanhänger 22
- Riesenwürfel 37
- Mini 24
- Sammlerstücke 57
- Mosaike 13
- Sets 29
- Andere 2
- Elektronische Puzzles
- Zubehör
- Hobby
- Lubes
- Outlet


Algorithmen für den Zauberwürfel schneller lernen: ein wissenschaftlich fundierter Guide
Jeder Speedcuber stößt früher oder später an dieselbe Wand. Die PLLs kannst du eigentlich, aber beim Wettkampf ist dein Kopf plötzlich leer. Gestern lief der Alg perfekt, heute weißt du nicht mehr, wie er anfängt. Ein Freund hat das komplette OLL in einem Monat gelernt, und bei dir sind nach einer Woche gerade mal drei Fälle hängen geblieben. Die gute Nachricht: Die Lernpsychologie erforscht genau diese Probleme seit über hundert Jahren und hat dafür ziemlich konkrete Antworten. In diesem Guide haben wir zusammengetragen, was diese Forschung für das Lernen von Algorithmen, für dein Training und für das Blindfold-Lösen bedeutet.
Am Anfang findest du einen kurzen Spickzettel, falls du einfach wissen willst, was du tun sollst. Danach folgt die ausführliche Besprechung: warum das funktioniert, woher wir das wissen und wo die Wissenschaft aufhört und die Vermutungen anfangen.
- Das Wichtigste in 2 Minuten
- Was wir wissen – und was nicht
- „Ich kann den Alg“ – drei verschiedene Fähigkeiten
- Wenig, aber jeden Tag
- Abfragen statt Lesen
- Trigger: Zerlege den Alg in Bausteine
- Langsam oder schnell?
- Gespiegelte und ähnliche Algs
- Fälle erkennen
- Schlaf und Pausen
- Algorithmen sind nicht alles: Pausen
- Was du wann lernen solltest (CFOP, Ortega)
- Plan: komplettes PLL in 3 Wochen
- Gewohnheit und Motivation
- Wettkämpfe und Stress
- Blindfold und Multi-Blind: Gedächtnis ist Technik
- Mythen über das Lernen von Algorithmen
- Quellen
1. Das Wichtigste in 2 Minuten
- Lerne jeden Tag 10–20 Minuten statt einmal pro Woche zwei Stunden. Zeitlich verteiltes Lernen ist einer der am besten belegten Effekte der gesamten Psychologie.
- 1–2 neue Algorithmen pro Tag reichen. Zehn auf einmal merkst du dir bis morgen, aber nicht für den nächsten Monat.
- Frag dich ohne Spickzettel ab. Stell den Fall ein, führe den Alg aus dem Gedächtnis aus und kontrolliere erst danach. Bloßes Draufschauen auf den Zettel gaukelt dir vor, dass du ihn kannst.
- Wiederhole jeden neuen Alg am nächsten Tag, nach 3–4 Tagen, nach einer Woche und nach 2–3 Wochen.
- Teile den Alg in 2–4 Trigger auf (Sexy Move, Sledgehammer, Sune) statt in 14 einzelne Züge.
- Schau dir zuerst die Fingertricks im Video an und übe erst dann. Ein paar langsame Wiederholungen reichen, um dir die Züge zu merken – danach drehst du schnell, aber sauber.
- Lerne ähnliche Algs nicht am selben Tag (Ja und Jb, die vier T-förmigen OLLs). Die Spiegelversion eines Algs ist für deine Hände ein komplett neuer Alg.
- Übe das Erkennen an zufälligen Fällen, am besten mit einem Algorithmus-Trainer.
- Schlaf ausreichend, aber verlass dich nicht darauf, dass Schlaf deinen Alg von allein schneller macht. Schlaf schützt das, was du gelernt hast.
- Bei Zeiten von 20–30 Sekunden verlierst du am meisten durch Pausen im F2L, nicht durch fehlende Algorithmen. Mach langsame Solves, ohne anzuhalten.
- Für Blindfold brauchst du kein „gutes Gedächtnis“. Buchstabenpaare, die du in Bilder umwandelst, sind eine Technik, die jeder lernen kann.
2. Was wir wissen – und was nicht
Bevor wir ins Detail gehen, ein ehrlicher Hinweis. Bisher hat noch niemand wissenschaftlich untersucht, wie man Algorithmen für den Cube am besten lernt. Es gibt einzelne Arbeiten über Speedcuber, aber keine vergleicht Methoden zum Lernen von Algs. Alles, was wir unten schreiben, ist eine Übertragung von Ergebnissen aus der Forschung zu ähnlichen Aufgaben: dem Lernen von Fingerbewegungsfolgen (z. B. Tippsequenzen auf einer Tastatur), dem Einprägen von Vokabeln und Fakten, dem Erlernen eines Instruments oder dem Training von Sportlern.
Einige dieser Ergebnisse sind sehr robust: Sie wurden durch Dutzende Studien und Metaanalysen bestätigt, also Arbeiten, die die Ergebnisse vieler Experimente zusammenfassen. Andere stammen aus einem einzigen Labor oder sind umstritten. Wo die Belege schwächer sind, sagen wir das klar. Die Quellen findest du am Ende in den Fußnoten.
3. „Ich kann den Alg“ – drei verschiedene Fähigkeiten
Wenn du sagst „Ich kann die T-Perm“, meinst du eigentlich drei Dinge gleichzeitig – und jedes davon lernst du ein bisschen anders:
- Einprägen: Du weißt, welche Züge zu diesem Fall gehören. Das ist ein Gedächtnis ähnlich wie beim Englischvokabeln-Lernen.
- Ausführen: Deine Finger drehen den Alg flüssig, ohne über den nächsten Zug nachzudenken. Das ist motorisches Gedächtnis, wie beim Klavierspielen.
- Erkennen: Ein Blick auf den Cube, und du weißt sofort, welcher Fall das ist. Das ist visuelles Gedächtnis, wie bei einem Schachspieler, der Tausende Stellungen kennt.
Die meisten typischen Lernfehler entstehen, weil diese drei Dinge verwechselt werden. Jemand dreht einen Alg 200-mal hintereinander (trainiert also das Ausführen) und wundert sich, dass er ihn eine Woche später nicht mehr weiß (weil er das Abrufen nicht geübt hat). Jemand anderes kennt alle Algs vom Zettel, verliert im Solve aber zwei Sekunden beim Erkennen des Falls. Die folgenden Kapitel behandeln jede dieser Fähigkeiten einzeln.
4. Wenig, aber jeden Tag
Wenn du dir aus dem ganzen Guide nur eine Sache merkst, dann diese: Dieselbe Lernmenge bringt viel mehr, wenn du sie auf viele kurze Einheiten verteilst. Psychologen nennen das den Spacing-Effekt (engl. spacing effect). Eine Metaanalyse mit über 300 Experimenten hat gezeigt, dass verteiltes Lernen das Lernen „am Stück“ schlägt – und je länger du dir etwas merken willst, desto größer sollten die Abstände zwischen den Wiederholungen sein[1]. Der Effekt gilt auch für motorische Fähigkeiten, am stärksten bei relativ einfachen Aufgaben[2].
Das Spannendste daran: Wir spüren es selbst nicht. In einer Studie mit Karteikarten brachte verteiltes Lernen bei 90 % der Teilnehmer bessere Ergebnisse – trotzdem waren 72 % von ihnen überzeugt, dass Pauken am Stück besser funktioniert hat[3]. Pauken fühlt sich am Ende des Abends super an und wirkt deshalb effektiv. Das Problem: Eine Woche später ist davon kaum noch etwas übrig.
Für das Lernen von Algorithmen heißt das ganz einfach: 1–2 neue Algs pro Tag, nicht jeden Tag, plus eine kurze Wiederholung der alten. Genau diesen Rat gibt J Perm seit Jahren für das komplette PLL[4]. Die Zahl „2“ selbst stammt nicht aus der Forschung, aber die Richtung passt perfekt dazu.
Wenn du eine Karteikarten-App wie Anki nutzt, mach dir über die Einstellungen nicht zu viele Gedanken. Studien haben nicht gezeigt, dass immer länger werdende Abstände zwischen den Wiederholungen besser sind als gleichbleibende[5]. Hauptsache, die Wiederholungen sind überhaupt auf viele Tage verteilt.
5. Abfragen statt Lesen
Die zweite Säule effektiven Lernens ist das aktive Abrufen (engl. retrieval practice). Jeder Versuch, etwas aus dem Gedächtnis hervorzuholen, festigt es stärker als erneutes Durchlesen. In einem klassischen Experiment lernten Studierende Wortpaare. Diejenigen, die sich weiter abfragten, wussten nach einer Woche noch etwa 80 %. Diejenigen, die nach dem ersten Erfolg nur noch weiterlasen, wussten etwa ein Drittel[6]. Metaanalysen Dutzender Studien bestätigen, dass dieser Effekt groß und gut reproduzierbar ist[7], und in einem Ranking von Lerntechniken bekamen genau das Abfragen und das zeitlich verteilte Lernen die besten Bewertungen. Wiederholtes Lesen und Unterstreichen schnitten schlecht ab[8].
Wichtig für den Cube: Der Effekt gilt nicht nur für Vokabeln. In einem Reanimationskurs führten Medizinstudierende, die statt der letzten 30 Übungsminuten einen Test absolvierten, die Maßnahme zwei Wochen später deutlich besser aus[9].
Wie überträgst du das auf Algorithmen?
- Während des Solves auf den Spickzettel zu schauen ist „Lesen“. Den Alg beim Anblick des Falls aus dem Gedächtnis auszuführen ist ein „Test“.
- Das Kriterium ist die korrekte Ausführung aus dem Gedächtnis, nicht die Anzahl der Wiederholungen. In einer großen Studie funktionierte folgendes Schema gut: 3 korrekte Abrufe in der ersten Einheit und danach jeweils einer in mehreren weiteren Einheiten, verteilt auf mehrere Tage. Zusätzliche Abrufe am ersten Tag brachten wenig, wenn man in den folgenden Einheiten sowieso zum Stoff zurückkehrte[10].
- Streich einen Alg nicht nach dem ersten Erfolg von der Liste. Wiederhole ihn am nächsten Tag, nach 3–4 Tagen, nach einer Woche und nach 2–3 Wochen. Dieser Zeitplan ist unsere Zusammenfassung von Ergebnissen aus der Vokabelforschung, kein getestetes Protokoll – aber er stimmt mit ihnen überein.
Pass auch auf die Illusion des Wissens auf. Solange der Spickzettel vor dir liegt, ist deine Einschätzung „das kann ich schon“ zu optimistisch[11]. Verlässlich beurteilen kannst du das erst nach einem Versuch ohne Zettel und mit etwas zeitlichem Abstand. Aus demselben Grund gilt: Miss deinen Fortschritt zu Beginn der nächsten Einheit, nicht am Ende der aktuellen. Wie gut ein Alg während des Übens läuft, sagt oft wenig darüber aus, wie viel wirklich im Gedächtnis bleibt[12]. Ein Top-Ergebnis nach 50 Wiederholungen ist Tagesform, kein dauerhaftes Lernen.
6. Trigger: Zerlege den Alg in Bausteine
Das Arbeitsgedächtnis, also das, was du in einem Moment im Kopf behalten kannst, fasst etwa 4 „Pakete“ an Informationen[13]. Vierzehn Züge als vierzehn einzelne Buchstaben sind zu viel. Derselbe Alg als drei bekannte Bausteine passt locker hinein.
Interessanterweise machen Menschen das ganz von selbst. In Studien zum Lernen langer Sequenzen teilten die Teilnehmer diese spontan in kurze, durch Pausen getrennte Stücke ein – und jeder etwas anders[14]. Speedcuber nennen solche Stücke Trigger: Sexy Move (R U R' U'), Sledgehammer (R' F R F'), Sune. In einem anderen Experiment half es beim Lernen einer Bewegungsfolge, sich sprachliche Namen für die Bewegungen zu merken[15]. Den Bausteinen Namen zu geben, ist also sinnvoll.
Zwei praktische Tipps:
- Teile den Alg dort, wo sich die Fingertricks ändern oder ein Regrip kommt, und nicht stur alle drei Züge. Die Grenzen zwischen den Bausteinen verfestigen sich und können später zu kleinen Pausen werden.
- Auf höherem Niveau ist das Ziel, die Bausteine zu einem Ganzen zu verschmelzen. Sobald du den Alg beherrschst, übe ihn so, dass zwischen den Triggern keine Lücke mehr entsteht.
Ein einfacher Test, ob ein Alg schon automatisiert ist: Führe ihn ein paarmal aus und zähle dabei im Kopf von 100 in Dreierschritten rückwärts. Wenn du hängen bleibst oder deutlich langsamer wirst, braucht der Alg noch Arbeit. Zweiter Test: Nach einer Woche ohne Wiederholung führst du ihn sofort und ohne Nachdenken aus.
7. Langsam oder schnell?
Oft hört man den Rat „Übe immer langsam, die Geschwindigkeit kommt von allein“. Die Forschung bestätigt das nicht. In einem Experiment, in dem die Teilnehmer kurze Sequenzen auf einer Tastatur übten, entwickelte die Gruppe mit der Anweisung „Arbeite schnell, mach dir keine Sorgen um Fehler“ eine bessere Fähigkeit, die ganze Sequenz flüssig auszuführen. Die Gruppe mit der Anweisung „Arbeite genau“ lernte eher, auf jedes Element einzeln zu reagieren[16]. Das ist ein Ergebnis aus einem einzigen Labor, aber es lohnt sich, darüber nachzudenken: Fingertricks, die nur sehr langsam geübt werden, können Griffe festigen, die bei hohem Tempo nicht funktionieren.
Eine sinnvolle Kombination sieht so aus:
- Schau dir ein Video mit den Fingertricks an, am besten aus der Perspektive der Person, die löst. Eine Metaanalyse zum Lernen durch Beobachtung hat gezeigt, dass Zuschauen vor allem die Art der Bewegungsausführung verbessert, weniger das Ergebnis selbst[17]. Schau vor dem Üben, nicht danach.
- Mach 5–10 langsame Wiederholungen, um dir die Zugfolge und die Fingerhaltung einzuprägen.
- Dreh dann „so schnell wie möglich, aber sauber“ und akzeptiere, dass du dich manchmal vertust.
Und was ist mit dem beliebten „Fehler brennen sich ein, also mach nie welche“? Wir haben keine Studien gefunden, die das bestätigen. Ein Fehler, den du sofort bemerkst und korrigierst, ist ein normaler Teil des Lernens.
8. Gespiegelte und ähnliche Algs
„Jb ist doch nur die Spiegelung von Ja, den bekomme ich gratis dazu.“ Leider nicht. In Studien zu Fingerbewegungsfolgen übertrug sich der Fortschritt bei einer Sequenz praktisch nicht auf dieselbe Sequenz in anderer Reihenfolge[18]. Bei Kindern und Jugendlichen im Alter von 9–17 Jahren übertrug sich eine eingeübte Sequenz teilweise auf die andere Hand, aber nur sehr schwach auf die umgekehrte Sequenz[19]. Für deine Finger ist ein gespiegelter Alg einfach ein neuer Alg und braucht eigene Wiederholungen. Beim Einprägen hilft es dagegen: Wenn du Ja kannst, versuch Jb selbst herzuleiten, bevor du nachschaust.
Der zweite Punkt ist die Reihenfolge beim Lernen ähnlicher Algs. Eine frisch geübte Sequenz ist einige Stunden lang störanfällig. Als Teilnehmer eine zweite, ähnliche Sequenz 2 Stunden nach der ersten lernten, blieb bei der ersten die Verbesserung aus, die man normalerweise am nächsten Tag sieht. Bei 8 Stunden Abstand gab es kein Problem[20]. Untersucht wurden einfache Fingersequenzen, für den Cube ist das also eine Schlussfolgerung und keine Gewissheit – aber die Regel ist simpel: Lerne pro Tag nur einen Alg aus einer „Familie“. Ja heute, Jb morgen oder nächste Woche. Die vier T-förmigen OLLs verteilst du auf mehrere Tage.
9. Fälle erkennen
Schachspieler auf Meisterniveau können nach wenigen Sekunden Hinsehen eine Stellung aus einer echten Partie viel besser rekonstruieren als Amateure. Werden die Figuren aber zufällig aufgestellt, verschwindet ihr Vorsprung fast völlig[21]. Sie haben kein besseres Gedächtnis, sondern Tausende abgespeicherte Muster. Beim Erkennen von OLL und PLL ist es genauso: Das ist eine eigene Fähigkeit und muss eigens trainiert werden.
Hier hilft das Mischen (engl. interleaving). Wenn du Fälle aus einer Familie in zufälliger Reihenfolge übst, lernst du besser, sie voneinander zu unterscheiden. Eine Metaanalyse hat gezeigt, dass dieser Effekt genau dann am stärksten ist, wenn sich die zu unterscheidenden Dinge ähneln[22]. In einer Studie, in der die Teilnehmer lernten, den Stil verschiedener Maler zu erkennen, brachten gemischte Bilder bessere Ergebnisse – trotzdem glaubten die meisten, dass sie in Blöcken besser gelernt hätten[23]. Beim Training laufen zufällige Fälle also schlechter, und das ist völlig normal.
Aber Achtung: Bei der reinen Ausführung der Bewegungen ist die Sache weniger eindeutig. In einer neuen Metaanalyse motorischer Studien war der Vorteil von zufälligem Üben für die Übertragung auf neue Varianten einer Aufgabe bei jüngeren Teilnehmern sehr gering[24]. Am besten kombinierst du deshalb beide Ansätze:
- Übe einen neuen Alg im Block, bis du ihn ausführst, ohne über den nächsten Zug nachzudenken.
- Übe das Erkennen im Trainer an zufälligen Fällen, mit einigen ähnlichen Fällen im Pool, und achte auf deine Reaktionszeit, nicht nur darauf, ob du richtig lagst. Studien zum sogenannten perzeptuellen Lernen zeigen, dass viele kurze Versuche mit sofortigem Feedback sowohl die Trefferquote als auch die Geschwindigkeit beim Erkennen verbessern[25].
- Lerne, PLLs an zwei Seiten zu erkennen, nicht an vier. Am bekanntesten ist das System von Sarah Strong[26]. Zu seiner Wirksamkeit gibt es keine Studien, aber es passt gut dazu, wie Experten Muster erkennen.
10. Schlaf und Pausen
„Schlaf eine Nacht drüber, dann bist du morgen schneller“
Dieser Rat hat eine konkrete Quelle. In einer bekannten Studie aus dem Jahr 2002 tippten die Teilnehmer eine Sequenz nach einer Nacht Schlaf etwa 20 % schneller, während nach derselben Zeit im Wachzustand keine solche Verbesserung auftrat[27]. Spätere Analysen haben dieses Ergebnis jedoch infrage gestellt. Eine große Metaanalyse zeigte: Berücksichtigt man die Ermüdung am Ende des Trainings und die Tageszeit, gibt es keine überzeugenden Belege dafür, dass Schlaf die Ausführung einer eingeübten Sequenz beschleunigt[28]. Eine erneute Analyse derselben Studien ergab außerdem, dass vor allem „erfolgreiche“ Ergebnisse veröffentlicht wurden – nach einer Korrektur verschwindet der Gewinn durch Schlaf[29]. Die wissenschaftliche Debatte läuft noch, aber die sichere Schlussfolgerung lautet: Verlass dich nicht auf Schlaf als Quelle für Speed, sondern als Schutz für das, was du gelernt hast.
Anders sieht es beim Einprägen aus, also bei der Frage, welche Züge zu welchem Fall gehören. Vokabeln, die kurz vor dem Schlafengehen gelernt wurden, blieben besser im Gedächtnis als solche, nach denen ein langer Tag folgte[30]. Eine gute Gewohnheit ist deshalb: neue Algs abends lernen und morgens zum ersten Mal wiederholen.
Und dann der Schlaf selbst: Für 13- bis 18-Jährige werden 8–10 Stunden Schlaf pro Nacht empfohlen[31]. Nächtliche Sessions bis ein Uhr vor einem Schultag kosten dich beim Lernen wirklich etwas – nicht nur Müdigkeit.
Pausen während des Übens
Vor einigen Jahren sorgte eine Studie für Aufsehen, nach der das Gehirn „in den Pausen lernt“: Der Fortschritt zeigte sich vor allem in kurzen, 10-sekündigen Ruhephasen zwischen den Durchgängen[32]. Eine neuere und viel größere Studie hat diese Schlussfolgerung infrage gestellt. Gruppen, die mit und ohne Pausen übten, erreichten am Ende dasselbe Ergebnis[33]. Kurze Pausen zwischen den Durchgängen sind in Ordnung, weil sie die Hände entlasten und helfen, die Qualität der Bewegungen zu halten. Entscheidend ist aber vor allem die Anzahl guter Wiederholungen, verteilt auf viele Tage.
11. Algorithmen sind nicht alles: Pausen
Es gibt nur sehr wenige Studien über Speedcuber selbst, aber eine davon ist fürs Training besonders nützlich. Die Autoren analysierten Bild für Bild 69 Solves von 16 Personen auf YouTube und kombinierten das mit einer großen Umfrage in der r/Cubers-Community[34]. Die Ergebnisse:
- Eine Person mit Zeiten um 20 Sekunden steht fast die Hälfte des Solves (46 %) still, eine Person mit Zeiten um 10 Sekunden ein Drittel,
- F2L ist die längste Phase des Solves, und dort gibt es die meisten Pausen,
- die Anzahl der Regrips hing stark mit der Zeit zusammen,
- die Anzahl der Züge im F2L hatte praktisch keinen Zusammenhang mit der Zeit.
Das sind Daten aus einer kleinen Gruppe, und sie zeigen Zusammenhänge, keine Ursachen – aber die Schlussfolgerung ist klar: Bei Zeiten von 20–30 Sekunden bringen dir Flüssigkeit und Look-ahead (der Blick auf das nächste Paar, bevor du das aktuelle fertig hast) mehr als weitere Algorithmen. Feliks Zemdegs empfiehlt dafür seit Jahren langsame Solves ohne Timer: Du drehst langsamer, aber ohne anzuhalten. In seinem Kommentar zu seinem Rekord-Average beschreibt er außerdem, dass er das OLL schon beim Einsetzen des letzten Paares vorhergesehen hat und deshalb vor dem OLL keine Pause entstand[35].
12. Was du wann lernen solltest (CFOP, Ortega)
3x3 mit der CFOP-Methode
Unter den Autoren von Tutorials herrscht Einigkeit über die Reihenfolge[4, 35]:
- 2-Look OLL und 2-Look PLL (zusammen 16 Algs) direkt nach der Anfängermethode.
- Komplettes PLL (21 Algs) als Erstes, weil es wenige sind und sie in jedem Solve vorkommen.
- Komplettes OLL (57 Algs) später. J Perm rät, sie „Form für Form“ zu lernen, und wir ergänzen: Verteil eine Form auf 2–3 aufeinanderfolgende Tage, damit sich ähnliche Algs nicht in die Quere kommen.
- Weitere Sets (COLL, ZBLL und andere) erst bei wirklich schnellen Zeiten.
Realistisch ist in der Community ein Tempo von 1–3 neuen Algs pro Tag und das komplette OLL in 1–2 Monaten. Versprechen wie „das ganze OLL in drei Wochen“ liefern keinerlei Daten dazu, wie viel davon nach einem Monat noch im Gedächtnis ist.
2x2 mit der Ortega-Methode
Ortega besteht aus 12 Algorithmen: 7 für die Orientierung der letzten Ebene und 5 für die Permutation beider Ebenen (PBL). Die ersten sind dieselben Algs wie im 2-Look OLL auf dem 3x3 (Sune, Antisune und Co.) – wenn du sie kennst, musst du also eigentlich nur 5 neue Algs lernen. Dafür reicht eine Woche, danach steckst du deine Energie am besten in die Planung des Solves während der Inspection. Das ist kein Forschungsergebnis, sondern Erfahrung aus der Praxis. Niemand hat das Lernen von Ortega untersucht.
Wie lange dauert das?
Laut einer großen Umfrage unter aktiven Speedcubern lag der typische beste Durchschnitt aus 12 Solves bei etwa 28 Sekunden nach 3 Monaten, etwa 20 Sekunden nach einem Jahr und etwa 15 Sekunden nach 3 Jahren Cubing[36]. Das sind Angaben von Leuten, die beim Hobby geblieben sind und Lust hatten, die Umfrage auszufüllen – nimm sie also nur als grobe Orientierung. Die Streuung ist riesig: Manche kommen in wenigen Monaten unter 20 Sekunden, andere erst nach einigen Jahren. Meist hängt das von der Anzahl der Solves pro Tag ab, aber nicht nur. In der einzigen längeren Studie mit Personen, die das Lösen des Cubes von null an lernten, hing der Lernerfolg mit allgemeinen Denkfähigkeiten zusammen, nicht mit Ausdauer oder Einstellung[37]. Wenn ein Freund 15 Sekunden schafft und du 25, heißt das nicht, dass du dich nicht anstrengst.
Noch etwas Wichtiges: Eine neue Technik verschlechtert deine Zeiten erst einmal. Wenn du von 2-Look auf komplettes PLL umsteigst oder deinen Griff änderst, kannst du 2–4 Wochen langsamer sein. Kehr nicht nach einem schwachen Ao12 zur alten Methode zurück. Selbst Tymon Kolasiński gab nach seinem Wechsel zur ZB-Methode im Herbst 2024 noch Monate später zu, dass er langsamer löst als vorher[38].
13. Plan: komplettes PLL in 3 Wochen
Der folgende Plan ist unsere Schlussfolgerung aus den oben beschriebenen Studien und keine an Speedcubern getestete Methode. Wir gehen davon aus, dass du 2-Look PLL (6 Algs) schon kannst und 15 neue lernen musst. Du brauchst 15–25 Minuten pro Tag für die Algs und zusätzlich Zeit für normale Solves.
So lernst du einen neuen Alg (ca. 10 Minuten)
- Schau dir das Video mit den Fingertricks an.
- Prüf am Cube, was der Alg macht: Welche Teile vertauscht er?
- Teile ihn in 2–4 Trigger und gib ihnen eigene Namen.
- Mach 5–10 langsame Wiederholungen, dann 2–3 Minuten „schnell, aber sauber“.
- Stell den Fall ein, dreh den Zettel um, führe den Alg aus dem Gedächtnis aus. Wiederhole das, bis du ihn 3-mal richtig geschafft hast, und streu dabei Algs aus den vorherigen Tagen ein.
- Fertig. An diesem Tag lernst du nichts Ähnliches mehr.
Erste Woche
| Tag | Abends (15–25 Min.) | Morgens (5 Min.) | Solves |
|---|---|---|---|
| Mo | Neu: T, Y | - | 10 langsame Solves ohne Pausen |
| Di | Neu: Aa, Ua; T und Y einmal aus dem Gedächtnis | T, Y aus dem Gedächtnis | 10 langsame Solves |
| Mi | Keine neuen. Trainer: T, Y, Aa, Ua + alte Algs, zufällig, 10 Min. | Aa, Ua aus dem Gedächtnis | 10 langsame Solves |
| Do | Neu: Ja, Ra (ohne Jb und Rb!); Wiederholung Aa, Ua; Check T, Y | Ja, Ra aus dem Gedächtnis | 10 langsame Solves |
| Fr | Neu: F, Ga; Wiederholung Ja, Ra; Check Aa, Ua | F, Ga aus dem Gedächtnis | 10 langsame Solves |
| Sa | Keine neuen. Trainer mit allen neuen Algs, 15 Min. Notiere, bei welchen du länger als 2 Sekunden überlegst. | - | Ao12 auf Zeit: Wochentest |
| So | Algfrei oder 5 Minuten Trainer | - | Cuben zum Spaß |
Zweite und dritte Woche
In der zweiten Woche kommen die Spiegelpaare und „Verwandten“ der Algs aus der ersten Woche dran: Jb, Rb am Montag, Ab, Ub am Dienstag, Gb, Nb am Donnerstag, Gc, Na am Freitag. Nach einer Woche Abstand hilft die Ähnlichkeit beim Unterscheiden, statt zu stören. Am Mittwoch und Samstag übst du im Trainer das komplette Set und fragst die Algs aus der ersten Woche aus dem Gedächtnis ab.
In der dritten Woche bleiben die letzten: Gd, E, V. Die übrigen Tage sind für Wiederholungen aus der zweiten Woche und Erkennungstraining an zwei Seiten da, in zufälliger Reihenfolge und mit Messung der Reaktionszeit. In den folgenden 2 Wochen führst du alle paar Tage jedes PLL einmal aus dem Gedächtnis aus. Danach sorgen normale Solves von selbst für die Wiederholungen.
Das komplette OLL kannst du nach demselben Schema üben: 1–3 neue Algs pro Tag an 4 Tagen pro Woche ergeben ungefähr 6–10 Wochen.
14. Gewohnheit und Motivation
„21 Tage, und die Gewohnheit sitzt“ ist ein Mythos. In einer Studie, in der die Teilnehmer eine neue tägliche Gewohnheit einführten, dauerte es im Schnitt 66 Tage, bis sie „automatisch“ lief – je nach Person zwischen 18 und 254 Tagen. Ein einzelner ausgelassener Tag schadete dem Fortschritt nicht[39]. Mach dir also keinen Kopf wegen eines Tages Pause, aber bleib regelmäßig dran.
Der wirksamste Weg zu Regelmäßigkeit ist ein „Wenn … dann …“-Plan. Nicht „Ich übe mehr“, sondern „Wenn es 19:00 Uhr ist und ich zu Abend gegessen habe, dann setze ich mich an den Schreibtisch und mache 15 Minuten PLL“. Eine Metaanalyse von fast hundert solcher Studien zeigte, dass ein konkreter Plan die Chance deutlich erhöht, dass du tatsächlich tust, was du dir vorgenommen hast[40].
Gut zu wissen: Die Stundenzahl allein ist nicht alles. Die berühmten „10.000 Stunden“ sind stark übertrieben: Gezieltes Training erklärte in Studien ungefähr ein Viertel der Leistungsunterschiede bei Spielen, ein Fünftel in der Musik und etwas weniger im Sport[41]. Am meisten bringt Training mit einem konkreten Ziel, mit Feedback und einem Schwierigkeitsgrad, der ein kleines bisschen zu hoch ist. Hundert Solves, ohne darüber nachzudenken, was schiefgelaufen ist, sind einfach viel Drehen – kein Training.
Ein Prozessziel für die Woche („Ich lerne 4 neue PLLs und mache 50 langsame Solves“) ist besser als ein Ergebnisziel („Ich komme unter 20 Sekunden“), weil das Ergebnis auch von Scrambles und Glück abhängt.
15. Wettkämpfe und Stress
Das Hängenbleiben unter Druck hat einen gut beschriebenen Mechanismus: Im Stress fängst du an, Bewegungen bewusst zu kontrollieren, die du normalerweise automatisch machst – und genau das bringt sie durcheinander. In einer Studie mit Golfern schützte Training vor Kamera und Zuschauern davor, unter Druck einzubrechen, Training nur mit Ablenkung dagegen nicht[42]. Für Speedcuber heißt das: Übe vor Wettkämpfen vor anderen Leuten oder film deine Solves.
Was noch hilft:
- Eine feste Routine vor dem Solve. Jedes Mal dieselben Schritte: Atmen, Hände positionieren, Blick aufs Kreuz. Eine Metaanalyse sportwissenschaftlicher Studien zeigte, dass Routinen vor dem Start die Leistung verbessern – unabhängig von Alter und Niveau[43].
- „Ich bin aufgeregt – im positiven Sinn“ statt „Beruhig dich“. Wenn dein Herz schneller schlägt, ist es leichter, das als Vorfreude zu deuten, als dich runterzufahren. In Experimenten schnitten Personen, die sich sagten „Ich freue mich darauf“, besser ab als diejenigen, die versuchten, sich zu beruhigen[44].
- Denk an eine konkrete Aufgabe („Schau aufs nächste Paar“), nicht an die Zeit.
- Denk an das Average-Format. Von fünf Solves werden der schlechteste und der beste gestrichen, ein Hänger macht also nicht dein ganzes Ergebnis kaputt.
Mit deinem ersten Wettkampf musst du nicht bis Sub-15 warten. Bei WCA-Wettkämpfen treten Leute auf jedem Niveau an, und aus jedem Start nimmst du mehr mit als aus einer Woche Üben zu Hause.
16. Blindfold und Multi-Blind: Gedächtnis ist Technik
Beim Blindfold-Lösen drehen sich die Verhältnisse um. Es gibt nur wenige Algorithmen, und es geht fast nur ums Gedächtnis. Hier hat die Wissenschaft eine gute Nachricht für dich: Ein außergewöhnliches Gedächtnis ist zum allergrößten Teil trainierte Technik, kein angeborenes Talent.
Gedächtnismeister haben kein anderes Gehirn
- In einer Studie mit den besten Teilnehmern von Gedächtniswettbewerben fand man im Vergleich zu anderen Menschen keine Unterschiede im Gehirnaufbau oder in der Intelligenz. Der Unterschied lag in der Methode: Fast alle nutzten einen Gedächtnispalast[45].
- Ganz normale Menschen, die 6 Wochen lang täglich 30 Minuten mit dem Gedächtnispalast trainierten, merkten sich in 5 Minuten mehr als doppelt so viele Wörter wie zu Beginn – und der Effekt hielt auch nach 4 Monaten noch an[46]. Eine Metaanalyse zu dieser Methode bestätigt, dass sie funktioniert[47].
- Ein Student, der im Labor über 230 Stunden das Merken von Ziffern trainierte, steigerte sich von 7 auf 79 Ziffern. Sein Kurzzeitgedächtnis wurde nicht größer – er lernte, Zifferngruppen in ihm bekannte Laufzeiten umzuwandeln[48]. Das ist genau derselbe Trick wie die Buchstabenpaare beim Blindfold.
- „Gehirntraining“-Apps verbessern das Gedächtnis nicht über die Übungen in der App hinaus[49]. Übe mit echtem Material: Buchstabenpaaren, Bildern, Routen.
Marcin Kowalczyk, ehemaliger Weltrekordhalter im Multi-Blind, sagt, dass er sein Gehirn nicht für außergewöhnlich hält – vor dem Training schnitt er in Gedächtnistests gut ab, aber nicht sensationell. Er rät außerdem, vor allem auf ausreichend Schlaf zu achten[50].
So merken sich die Besten alles
Praktiker nutzen übereinstimmend dasselbe Schema[51]:
- Jeder Sticker hat seinen Buchstaben (das beliebteste Schema ist Speffz).
- Du verbindest die Buchstaben zu Paaren und machst aus jedem Paar ein Bild oder ein Wort: KR wird zum Krokodil, ST zum Stuhl.
- Die Bilder verknüpfst du zu einer kurzen Geschichte. Wichtig ist, dass die Elemente etwas miteinander machen: Das Krokodil zerbeißt den Stuhl – nicht „Krokodil und Stuhl“.
- Bau deine Paarliste auf Deutsch auf. Englische Listen aus dem Internet funktionieren nicht, weil die Wörter für dich natürlich sein müssen.
- Am Anfang kannst du die Buchstaben auf einen Zettel schreiben, um nur die Methode zu lernen, ohne Stress ums Merken.
Müssen die Bilder schräg sein? Weniger, als man sagt. Skurrilität hilft vor allem dann, wenn sich ein paar schräge Bilder von normalen abheben. Wenn alle absurd sind, verschwindet der Vorteil[52]. Setz lieber auf konkrete, deutliche Gegenstände, die miteinander interagieren.
Beim einzelnen Cube merken sich viele die Kanten als Bilder oder Geschichte und die Ecken (bzw. den letzten Teil) als rhythmischen „Abzählreim“, den sie im Kopf wiederholen und als Erstes ausführen. Dieses klangliche Gedächtnis ist sehr kurz – sprich also zwischen Merken und Ausführen mit niemandem und hör dir nichts an. In unserem Kurs zum 3x3-Blindfold-Lösen findest du eine fertige Methode mit Beispielen für Buchstabenpaare.
Multi-Blind
Bei mehreren Cubes reicht das kurze klangliche Gedächtnis nicht mehr, und alle steigen auf den Gedächtnispalast um: ein Cube ist ein Raum, und darin gibt es 2–3 deutlich unterschiedliche Orte für die Bilder. Aus der Gedächtnisforschung ergeben sich drei Tipps:
- Die Mitte merkst du dir am schlechtesten. Elemente vom Anfang und Ende einer Liste bleiben besser hängen als die aus der Mitte[53], also brauchen die mittleren Cubes eine zusätzliche Wiederholung.
- Die Orte müssen sich deutlich unterscheiden. Ähnliche Bilder an ähnlichen Orten vermischen sich.
- Wiederhole zwischendurch, nicht nur am Ende. Geh nach jedem neuen Cube gedanklich die vorherigen durch, und leg dir bei mehr Cubes ein festes Wiederholungsschema zu.
Wie sieht das bei den Besten aus? Graham Siggins löste bei einem inoffiziellen Versuch im Jahr 2025 319 von 350 Cubes. Allein das Memorieren dauerte etwa 12 Stunden, das Lösen etwa zwei[54]. Das Memorieren nimmt auf jedem Niveau den Großteil der Zeit ein, auch am Anfang: Die ersten erfolgreichen Versuche dauern meist ein paar Minuten, davon ist das meiste Memo.
Stress bei Wettkämpfen erschwert das Abrufen, vor allem von Dingen, die nur schwach eingeprägt waren[55]. Wiederhole dein Memo bei Wettkämpfen deshalb einmal öfter als zu Hause und übe unter wettkampfähnlichen Bedingungen: ein Versuch, jemand schaut zu. Und prüf nach jedem DNF, wo der Fehler lag: beim Merken oder beim Ausführen. Bei den meisten versagt öfter die Ausführung als das Gedächtnis.
Wenn du loslegen willst, haben wir auch Kurse zu Multi-Blind, 4x4 Blindfold und 5x5 Blindfold.
17. Mythen über das Lernen von Algorithmen
| Mythos | Was die Forschung sagt |
|---|---|
| „Schlaf eine Nacht über den neuen Alg, dann bist du morgen 20 % schneller“ | Neuere Analysen bestätigen das nicht. Schlaf schützt das Gedächtnis, bringt aber keinen Speed[28, 29]. |
| „Übe immer langsam, die Geschwindigkeit kommt von allein“ | Ein paar langsame Wiederholungen ja, danach schnell, aber sauber[16]. |
| „Den gespiegelten Alg bekommst du gratis dazu“ | Für die Finger ist das eine neue Sequenz[18, 19]. |
| „Dreh den Alg an einem Abend 200-mal“ | Viele Wiederholungen an einem Tag wirken nur kurz. Besser 3 korrekte Abrufe heute und je einer an den folgenden Tagen[10]. |
| „Wenn ich ihn heute kann, kann ich ihn“ | Mit Spickzettel schätzt du dich zu gut ein. Frag dich morgen ohne Zettel ab[11]. |
| „Spar Züge im F2L“ | In den einzigen verfügbaren Daten hatte die Anzahl der Züge im F2L keinen Zusammenhang mit der Zeit, Pausen und Regrips dagegen schon[34]. |
| „Ich bin ein visueller Typ, also lerne ich mit Bildern“ | Es gibt keine Belege dafür, dass es etwas bringt, das Lernen an einen „Lerntyp“ anzupassen[56]. |
| „21 Tage, und die Gewohnheit sitzt“ | Im Schnitt 66 Tage, je nach Person 18 bis 254[39]. |
| „10.000 Stunden, und du bist ein Meister“ | Es kommt auf die Qualität des Trainings an, und Unterschiede zwischen Menschen sind groß und normal[41]. |
| „Für Blindfold brauchst du ein fotografisches Gedächtnis“ | Gedächtnisrekordhalter nutzen Techniken, die jeder lernen kann[45, 46]. |
Zum Schluss: Die beste Methode ist die, an die du dich wirklich hältst. Plane in Monaten, nicht in Wochen, lerne wenig und regelmäßig, frag dich ab statt nur zu lesen, und freu dich über jede Sekunde, die du von deinem Average abknapst. Und wenn du mit Timer übst, probier unseren kostenlosen Online-Timer aus.
Quellen
Die meisten Quellen sind wissenschaftliche Arbeiten auf Englisch. Die Links führen zu Zusammenfassungen oder Volltexten.
- Cepeda, N. J., Pashler, H., Vul, E., Wixted, J. T., Rohrer, D. (2006). Distributed practice in verbal recall tasks: A review and quantitative synthesis. Psychological Bulletin, 132(3), 354–380. Metaanalyse von 839 Vergleichen aus 317 Experimenten. doi.org/10.1037/0033-2909.132.3.354
- Donovan, J. J., Radosevich, D. J. (1999). A meta-analytic review of the distribution of practice effect: Now you see it, now you don't. Journal of Applied Psychology, 84(5), 795–805. 63 Studien, Effekt am stärksten bei einfachen motorischen Aufgaben. doi.org/10.1037/0021-9010.84.5.795
- Kornell, N. (2009). Optimising learning using flashcards: Spacing is more effective than cramming. Applied Cognitive Psychology, 23(9), 1297–1317. doi.org/10.1002/acp.1537
- J Perm (Dylan Wang). CFOP Method und Last Layer, Online-Tutorials. jperm.net/3x3/cfop, jperm.net/3x3/cfop/ll
- Latimier, A., Peyre, H., Ramus, F. (2021). A meta-analytic review of the benefit of spacing out retrieval practice episodes on retention. Educational Psychology Review, 33(3), 959–987. doi.org/10.1007/s10648-020-09572-8
- Karpicke, J. D., Roediger, H. L. (2008). The critical importance of retrieval for learning. Science, 319(5865), 966–968. doi.org/10.1126/science.1152408
- Rowland, C. A. (2014). The effect of testing versus restudy on retention: A meta-analytic review of the testing effect. Psychological Bulletin, 140(6), 1432–1463. doi.org/10.1037/a0037559
- Dunlosky, J., Rawson, K. A., Marsh, E. J., Nathan, M. J., Willingham, D. T. (2013). Improving students' learning with effective learning techniques. Psychological Science in the Public Interest, 14(1), 4–58. doi.org/10.1177/1529100612453266
- Kromann, C. B., Jensen, M. L., Ringsted, C. (2009). The effect of testing on skills learning. Medical Education, 43(1), 21–27. Ergebnis nach 2 Wochen: 82,8 % gegenüber 73,3 %. doi.org/10.1111/j.1365-2923.2008.03245.x
- Rawson, K. A., Dunlosky, J. (2011). Optimizing schedules of retrieval practice for durable and efficient learning: How much is enough? Journal of Experimental Psychology: General, 140(3), 283–302. doi.org/10.1037/a0023956
- Koriat, A., Bjork, R. A. (2005). Illusions of competence in monitoring one's knowledge during study. Journal of Experimental Psychology: Learning, Memory, and Cognition, 31(2), 187–194. doi.org/10.1037/0278-7393.31.2.187
- Soderstrom, N. C., Bjork, R. A. (2015). Learning versus performance: An integrative review. Perspectives on Psychological Science, 10(2), 176–199. doi.org/10.1177/1745691615569000
- Cowan, N. (2001). The magical number 4 in short-term memory: A reconsideration of mental storage capacity. Behavioral and Brain Sciences, 24(1), 87–114. doi.org/10.1017/S0140525X01003922
- Sakai, K., Kitaguchi, K., Hikosaka, O. (2003). Chunking during human visuomotor sequence learning. Experimental Brain Research, 152(2), 229–242. doi.org/10.1007/s00221-003-1548-8
- Gidley Larson, J. C., Suchy, Y. (2015). The contribution of verbalization to action. Psychological Research, 79(4), 590–608. doi.org/10.1007/s00426-014-0586-0
- Barnhoorn, J. S., Panzer, S., Godde, B., Verwey, W. B. (2019). Training motor sequences: Effects of speed and accuracy instructions. Journal of Motor Behavior, 51(5), 540–550. doi.org/10.1080/00222895.2018.1528202
- Ashford, D., Bennett, S. J., Davids, K. (2006). Observational modeling effects for movement dynamics and movement outcome measures across differing task constraints: A meta-analysis. Journal of Motor Behavior, 38(3), 185–205. doi.org/10.3200/JMBR.38.3.185-205
- Karni, A. et al. (1998). The acquisition of skilled motor performance: Fast and slow experience-driven changes in primary motor cortex. PNAS, 95(3), 861–868. doi.org/10.1073/pnas.95.3.861
- Dorfberger, S., Adi-Japha, E., Karni, A. (2012). Sequence specific motor performance gains after memory consolidation in children and adolescents. PLoS ONE, 7(1), e28673. doi.org/10.1371/journal.pone.0028673
- Korman, M., Doyon, J., Doljansky, J., Carrier, J., Dagan, Y., Karni, A. (2007). Daytime sleep condenses the time course of motor memory consolidation. Nature Neuroscience, 10(9), 1206–1213. doi.org/10.1038/nn1959
- Chase, W. G., Simon, H. A. (1973). Perception in chess. Cognitive Psychology, 4(1), 55–81. doi.org/10.1016/0010-0285(73)90004-2
- Brunmair, M., Richter, T. (2019). Similarity matters: A meta-analysis of interleaved learning and its moderators. Psychological Bulletin, 145(11), 1029–1052. doi.org/10.1037/bul0000209
- Kornell, N., Bjork, R. A. (2008). Learning concepts and categories: Is spacing the „enemy of induction“? Psychological Science, 19(6), 585–592. doi.org/10.1111/j.1467-9280.2008.02127.x
- Czyż, S. H., Wójcik, A. M., Solarská, P. (2024). The effect of contextual interference on transfer in motor learning: A systematic review and meta-analysis. Frontiers in Psychology, 15, 1377122. doi.org/10.3389/fpsyg.2024.1377122
- Kellman, P. J., Massey, C. M. (2013). Perceptual learning, cognition, and expertise. Psychology of Learning and Motivation, 58, 117–165. doi.org/10.1016/B978-0-12-407237-4.00004-9
- Strong, S. 2-Side PLL Recognition Guide. sarah.cubing.net/3x3x3/pll-recognition-guide
- Walker, M. P., Brakefield, T., Morgan, A., Hobson, J. A., Stickgold, R. (2002). Practice with sleep makes perfect: Sleep-dependent motor skill learning. Neuron, 35(1), 205–211. doi.org/10.1016/S0896-6273(02)00746-8
- Pan, S. C., Rickard, T. C. (2015). Sleep and motor learning: Is there room for consolidation? Psychological Bulletin, 141(4), 812–834. Metaanalyse: 34 Artikel, 88 Gruppen, 1296 Personen. doi.org/10.1037/bul0000009
- Rickard, T. C., Pan, S. C., Gupta, M. W. (2022). Severe publication bias contributes to illusory sleep consolidation in the motor sequence learning literature. Journal of Experimental Psychology: Learning, Memory, and Cognition, 48(12), 1787–1796. doi.org/10.1037/xlm0001090
- Gais, S., Lucas, B., Born, J. (2006). Sleep after learning aids memory recall. Learning & Memory, 13(3), 259–262. doi.org/10.1101/lm.132106
- Paruthi, S. et al. (2016). Recommended amount of sleep for pediatric populations: A consensus statement of the American Academy of Sleep Medicine. Journal of Clinical Sleep Medicine, 12(6), 785–786. doi.org/10.5664/jcsm.5866
- Bönstrup, M., Iturrate, I., Thompson, R., Cruciani, G., Censor, N., Cohen, L. G. (2019). A rapid form of offline consolidation in skill learning. Current Biology, 29(8), 1346–1351. doi.org/10.1016/j.cub.2019.02.049
- Das, A., Karagiorgis, A., Diedrichsen, J., Stenner, M.-P., Azañón, E. (2025). Micro-offline gains do not reflect offline learning during early motor skill acquisition in humans. PNAS, 122(44), e2509233122. Fünf Experimente, 631 Personen. doi.org/10.1073/pnas.2509233122
- Boyce, K., Storm, C. (2022). Rubik's cube: What separates the fastest solvers from the rest? Journal of Emerging Investigators, 5. Analyse von 69 Solves von 16 Personen sowie einer r/Cubers-Umfrage (1385 Antworten). doi.org/10.59720/21-189
- Zemdegs, F. How To Get Faster? sowie 5.97 Reconstructions + Commentary (2017), CubeSkills-Blog. cubeskills.com/blog/how-to-get-faster, cubeskills.com/blog/597-reconstructions-commentary
- b4silio (2020). r/Cubers Mega-Survey 4: A quick analysis of the survey results (Diagramm „Impact of cubing experience“, bester Durchschnitt aus 12, Selbstangaben der Befragten). basilio.dev/cubing/RedditCubersMegasurvey.pdf
- Meinz, E. J., Hambrick, D. Z., Leach, J. K., Boschulte, P. J. (2023). Ability and nonability predictors of real-world skill acquisition: The case of Rubik's cube solving. Journal of Intelligence, 11(1), 18. doi.org/10.3390/jintelligence11010018
- GAN Cube (2025). Tymon Kolasiński: A Decade of Battles, Still a World Champion. gancube.com
- Lally, P., van Jaarsveld, C. H. M., Potts, H. W. W., Wardle, J. (2010). How are habits formed: Modelling habit formation in the real world. European Journal of Social Psychology, 40(6), 998–1009. doi.org/10.1002/ejsp.674
- Gollwitzer, P. M., Sheeran, P. (2006). Implementation intentions and goal achievement: A meta-analysis of effects and processes. Advances in Experimental Social Psychology, 38, 69–119. doi.org/10.1016/S0065-2601(06)38002-1
- Macnamara, B. N., Hambrick, D. Z., Oswald, F. L. (2014). Deliberate practice and performance in music, games, sports, education, and professions: A meta-analysis. Psychological Science, 25(8), 1608–1618. doi.org/10.1177/0956797614535810
- Beilock, S. L., Carr, T. H. (2001). On the fragility of skilled performance: What governs choking under pressure? Journal of Experimental Psychology: General, 130(4), 701–725. doi.org/10.1037/0096-3445.130.4.701
- Rupprecht, A. G. O., Tran, U. S., Gröpel, P. (2024, online 2021). The effectiveness of pre-performance routines in sports: A meta-analysis. International Review of Sport and Exercise Psychology, 17(1), 39–64. doi.org/10.1080/1750984X.2021.1944271
- Brooks, A. W. (2014). Get excited: Reappraising pre-performance anxiety as excitement. Journal of Experimental Psychology: General, 143(3), 1144–1158. doi.org/10.1037/a0035325
- Maguire, E. A., Valentine, E. R., Wilding, J. M., Kapur, N. (2003). Routes to remembering: the brains behind superior memory. Nature Neuroscience, 6(1), 90–95. doi.org/10.1038/nn988
- Dresler, M. et al. (2017). Mnemonic training reshapes brain networks to support superior memory. Neuron, 93(5), 1227–1235. doi.org/10.1016/j.neuron.2017.02.003
- Twomey, C., Kroneisen, M. (2021). The effectiveness of the loci method as a mnemonic device: Meta-analysis. Quarterly Journal of Experimental Psychology, 74(8), 1317–1326. doi.org/10.1177/1747021821993457
- Ericsson, K. A., Chase, W. G., Faloon, S. (1980). Acquisition of a memory skill. Science, 208(4448), 1181–1182. doi.org/10.1126/science.7375930
- Melby-Lervåg, M., Redick, T. S., Hulme, C. (2016). Working memory training does not improve performance on measures of intelligence or other measures of „far transfer“. Perspectives on Psychological Science, 11(4), 512–534. doi.org/10.1177/1745691616635612
- Creyos (Cambridge Brain Sciences). The man who can solve 41 Rubik's cubes while blindfolded has advice for doing amazing things with your brain (Interview mit Marcin Kowalczyk). cambridgebrainsciences.com
- J Perm. How To Solve a Rubik's Cube Blindfolded; Hardwick, C. Memorizing. jperm.net/bld, speedcubing.com/chris/memorizing.html
- McDaniel, M. A., Einstein, G. O. (1986). Bizarre imagery as an effective memory aid: The importance of distinctiveness. Journal of Experimental Psychology: Learning, Memory, and Cognition, 12(1), 54–65. doi.org/10.1037/0278-7393.12.1.54
- Glanzer, M., Cunitz, A. R. (1966). Two storage mechanisms in free recall. Journal of Verbal Learning and Verbal Behavior, 5(4), 351–360. doi.org/10.1016/S0022-5371(66)80044-0
- speedcubing.org (2025). Graham Siggins Solves 319 Cubes Blindfolded (inoffizieller Versuch, 6.12.2025). speedcubing.org
- Shields, G. S., Sazma, M. A., McCullough, A. M., Yonelinas, A. P. (2017). The effects of acute stress on episodic memory: A meta-analysis and integrative review. Psychological Bulletin, 143(6), 636–675. doi.org/10.1037/bul0000100
- Pashler, H., McDaniel, M., Rohrer, D., Bjork, R. (2008). Learning styles: Concepts and evidence. Psychological Science in the Public Interest, 9(3), 105–119. doi.org/10.1111/j.1539-6053.2009.01038.x
Zugehörige Produkte

QiYi SpeedCubing Timer
Vorheriger Preis49,99 zł Preis39,99 zł Rabatt-20% Speichern-10,00 złSpeedcubing-Timer mit Touch-Feldern für die Hände, die wie im Wettkampf...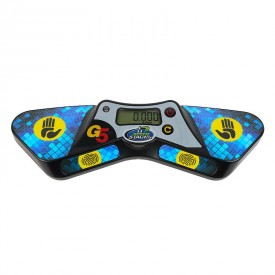
Set Speed Stacks Pro Gen 5 - Timer G5 + Bag
Vorheriger Preis159,99 zł Preis143,99 zł Rabatt-10% Speichern-16,00 złSet mit dem Speed Stacks G5 StackMat Pro Timer, dem Standard bei...
Matte QiYi Training Mat – Infinite Mind
Preis24,99 złDie QiYi Training Mat in der schwarzen Variante Infinite Mind misst ca. 49 x...
Z-Cube 3D-Augenbinde für Blindfold + Ohrstöpsel
Preis9,99 złZcube-Set für Training und Turniere im Blindfold: geformte, schwarze...
MoYu RS3M V5 Magnetic 3x3x3
Vorheriger Preis29,99 zł Preis28,49 zł Rabatt-5% Speichern-1,50 złDie Basisversion des MoYu RS3M V5, des Nachfolgers des RS3M 2020. Ein...
GAN 356M 3x3x3
Vorheriger Preis119,99 zł Preis89,99 zł Rabatt-25% Speichern-30,00 złMagnetischer 3x3-Cube von GAN mit 48 sichtbaren Magneten, stabilem und...
GAN V100 Maglev UV 3x3
Vorheriger Preis199,99 zł Preis179,99 zł Rabatt-10% Speichern-20,00 złKompakter GAN 3x3 in 55 mm mit nur ca. 64 g. Er hat MagLev, Core-Magnete und...
YuXin Black Kylin 3x3x3 v2
Preis14,99 złDer YuXin Black Kylin 3x3x3 v2 ist ein günstiger 3x3-Cube ohne Magnete, in...
Hinterlasse einen Kommentar
Ähnliche Beiträge
-
 Wie schmiert man einen Zauberwürfel? Der große Ratgeber zu Lubes für CubesAlles rund ums Schmieren von Cubes: Schmieren in 2 Minuten für Einsteiger, die Geschichte der Lubes seit 1980, Chemie...
- Geschenkratgeber zum Dzień Chłopaka (polnischer Jungentag)Was schenkst du einem Jungen zum Dzień Chłopaka? Geschenkideen: 3x3- und 4x4-Cube, Megaminx, Pyraminx, Mirror Cube...
- Fingerboard – was ist das?Was ist ein Fingerboard und was ist Fingerboarding? Die Geschichte der Mini-Skateboards, der Aufbau eines Boards,...